Paper Analyzer / Academic but Easier
ReViV:如何从一段第一视角视频,同时还原“我”和“我看到的世界”
对 ReViV: Reconstructing the Viewer and the View in 4D from Monocular Egocentric Video 的学术型深度解析。本文重点解释统一多模态建模为何能绕开相机误差串联、离散 token 如何承载身体与场景、以及实验究竟证明了什么。
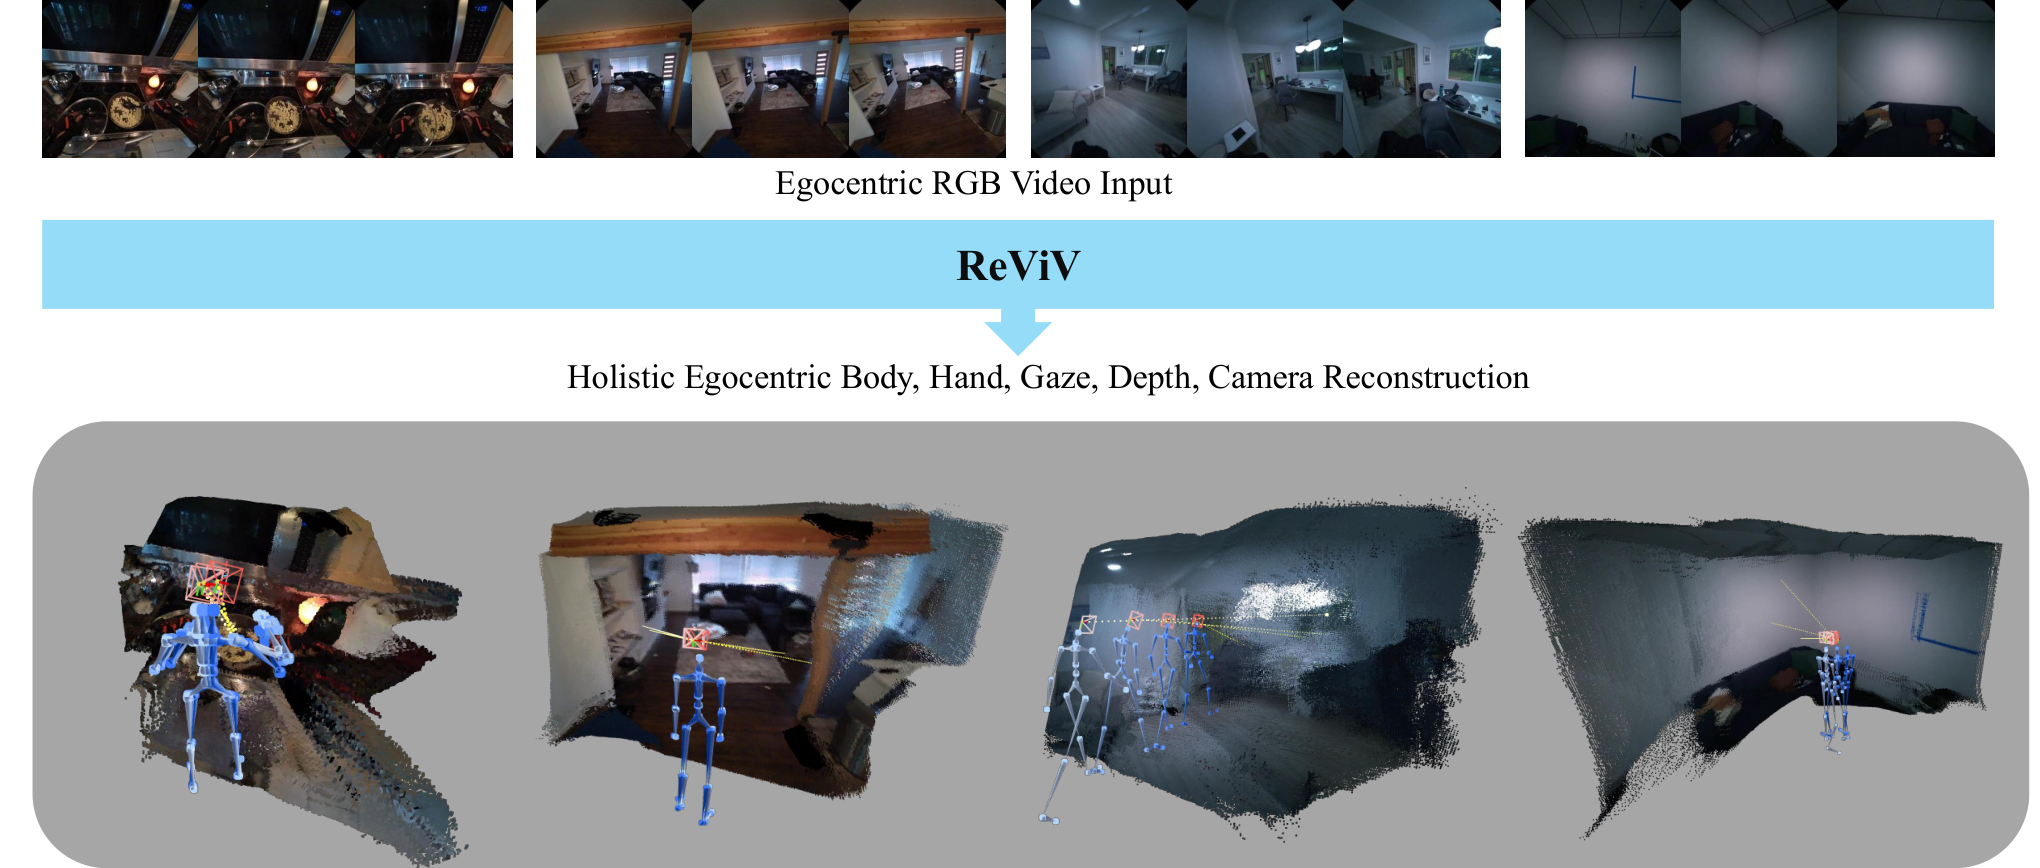
先给结论:这篇论文真正新在哪里
- 问题重写:不再把身体、手、视线、相机和深度当作五条独立流水线,而是学习六种信号的联合概率分布。
- 统一接口:不同模态先由各自 tokenizer 变成离散 token;同一个 MGET Transformer 再学习任意“已知模态 → 缺失模态”的条件预测。
- 关键收益:身体预测不必先吃一个可能漂移的 SLAM/相机轨迹;不可见的手和身体可借助时间与场景语义补全。
- 主要成绩:身体、手、视线达到最优或强竞争结果,单段推理约 0.7 秒;手部相对 Dyn-HaMR 快约 400 倍。
- 明确短板:深度仍落后于带 UniDepth 专家先验的 EgoMono4D;离散量化会损失高频几何细节,训练成本也非常高。
1. 论文元信息与一句话总结
论文定位
第一视角视觉、4D 重建、人体运动估计与多模态生成建模的交叉工作。输入是单目 RGB,输出覆盖 viewer 与 view。
发布状态
官方仓库包含训练、推理、六类 tokenizer、配置、示例视频与两套检查点说明;代码 Apache-2.0,模型权重限非商业研究。
训练规模
7B 个独特预训练 token,主模型总计消费约 500B token;256 张 H100 上约 24 小时,global batch 1024。
核心架构
12 层 encoder + 12 层 decoder、hidden dim 768 的 T5 式 MGET;仓库将 released base model 描述为约 400M 参数。
一句话总结:ReViV 把同一段第一视角经历翻译成 RGB、深度、相机、视线、身体和双手六种同步“语言”,通过随机遮住其中一些语言来训练模型互相补译;测试时只留下 RGB,模型便补全其余 4D 状态。
2. 研究背景与动机:为什么不能继续串联五个专家
佩戴相机的人几乎看不到自己的躯干,双手又经常离开画面;与此同时,相机运动、地面几何、正在操作的物体和身体动作彼此约束。传统做法常先求相机轨迹,再将轨迹交给人体模型,最后独立估计深度或视线。问题在于:前一级的误差会成为后一级不可逆的输入。
例如,头戴相机向右转时,画面整体向左运动。这个像素变化既可能来自头部/身体转动,也可能来自相机轨迹估计偏差;若先把一个错误轨迹“钉死”,后续身体模型只能在错误坐标系里自洽。ReViV 的选择是暂不强行拆因果链,而是让模型直接学习这些变量在数据中如何共同出现。
论文的关键表述是:“Rather than treating body motion, hand dynamics, gaze, camera trajectory, and depth as independent prediction tasks …”——它反对的不是专业模块本身,而是把强耦合变量过早拆开。
第二个难点是多解性。镜头只看到桌面时,佩戴者下半身可能站立、轻微迈步或保持静止;单帧并没有唯一答案。确定性回归容易输出各种可能姿态的平均值,结果常是动作僵硬。生成式条件分布允许模型保留多个合理解,再结合整段时间上下文缩小范围。
第三个难点来自数据:没有一个第一视角数据集同时拥有高质量 RGB、深度、相机、视线、手和全身标注。论文因此把“数据引擎”列为独立主章节,而不是把训练集当作附属细节。统一模型能否成立,首先取决于能否把不完整、坐标系不同的多数据集组织成共同 token 空间。
3. 预备知识:联合分布、VQ-VAE 与掩码生成
3.1 Viewer 与 View 分别是什么
| 侧别 | 模态 | 典型表示 | 本文角色 |
|---|---|---|---|
| 观测 | RGB 视频 | 离散 Cosmos token + 连续 ViT 特征 | 推理时唯一必需输入 |
| Viewer | 全身、左手、右手 | 随时间变化的 3D 关节 | 恢复相机佩戴者不可见或半可见的运动 |
| Viewer/View 接口 | 视线 | 归一化至 $[0,1]^2$ 的屏幕位置 | 连接注意目标与场景内容 |
| View | 相机轨迹、深度 | 位姿序列与逐帧深度图 | 恢复观察者在世界中的运动和可见几何 |
3.2 从确定性映射改成联合概率
论文 Equation (1)。
$\mathcal X$ 是已观测 RGB,$\mathcal Y$ 是需要重建的五类状态;每一项都是一段时间序列,而不是单帧标量。式子没有指定谁必须先预测:它声明模型要覆盖六种模态共同出现的概率结构,因此可以从任意可见子集条件化到任意缺失子集。
分析者根据论文联合分布目标写出的条件概率关系,不是论文新增编号公式。
测试时真正需要的是左侧:已知 RGB 后,身体、手、视线、深度和相机有哪些合理组合。学习联合分布的价值在于训练阶段可随意改变条件集合;代价是模型容量和数据覆盖必须足够,否则“全都能预测”可能变成“每项都只学到粗略相关性”。
3.3 VQ-VAE 为何能统一异构模态
RGB 是高维像素网格,相机是一串低维位姿,身体又是 $N\times J\times3$ 的关节张量。直接拼接连续数值会让量纲、长度和损失尺度互相冲突。VQ-VAE 先为每个模态学习自己的词表,再把连续片段替换成词表索引,主模型只需做分类式 token 预测。
标准 VQ 的结构化表达;论文以映射 $Q_m:\mathbb R^{D_m}\to\mathcal Z_m$ 和 codebook $\mathcal C_m\in\mathbb R^{K_m\times d}$ 描述同一过程。
$e_{m,i}\in\mathbb R^d$ 是模态 $m$ 的第 $i$ 个连续 latent,$\mathbf c_{m,k}$ 是第 $k$ 个 code;输出 $z_{m,i}$ 是整数索引。直觉上,这一步把无限精细的连续动作压成有限“动作音节”,方便 Transformer 预测,但细小误差也会在量化时被舍弃。
4. 方法详解
flowchart LR
  RGB[Monocular RGB clip] --> VTok[Cosmos RGB tokens]
  RGB --> ViT[Continuous ViT features]
  Data[Depth / camera / gaze / body / hands] --> VQ[Modality VQ-VAEs]
  VTok --> Z[Unified token set Z]
  VQ --> Z
  ViT --> MGET[MGET encoder-decoder]
  Z --> MGET
  MGET --> Masked[Masked token distributions]
  Masked --> Decode[3-step parallel decoding]
  Decode --> State[Body + hands + gaze + camera + depth]
  State --> Align[Floor or metric-depth alignment]
  Align --> FourD[Metric-aligned viewer-view 4D]
4.1 数据引擎:先让不完整数据能够共同训练
论文合并 EgoExo4D、HoloAssist、HOT3D、ARCTIC、TACO、H2O、EgoGen 与 Nymeria。它们拥有的模态并不相同:只有 Nymeria 提供全身,多个手部数据集没有视线,EgoExo4D 又没有深度。模型训练时不要求一条样本具备全部标签,而是通过掩码和 token budget 只消费当前样本真实存在的模态。
缺少真实深度的数据由 Video Depth Anything 生成时间一致的伪标签。这里要注意证据边界:伪标签扩大了几何监督覆盖,却不等于真实传感器深度;伪模型的系统偏差可能被 ReViV 学入。消融中移除 Nymeria 或同时移除 Nymeria 与 HoloAssist 后,深度与相机性能均下降,支持“数据规模有用”,但不能单独分离真实标签与伪标签质量的贡献。
坐标统一同样关键。双手被投影到各帧相机坐标,以消除全局行走轨迹;全身则进入重力对齐的世界坐标,以第一帧相机为参考并去掉初始俯仰/横滚。一个关注局部操作,一个保留全局导航,这比把所有关节硬塞进同一坐标系更符合任务结构。
4.2 统一离散表示:每种模态有自己的“词典”
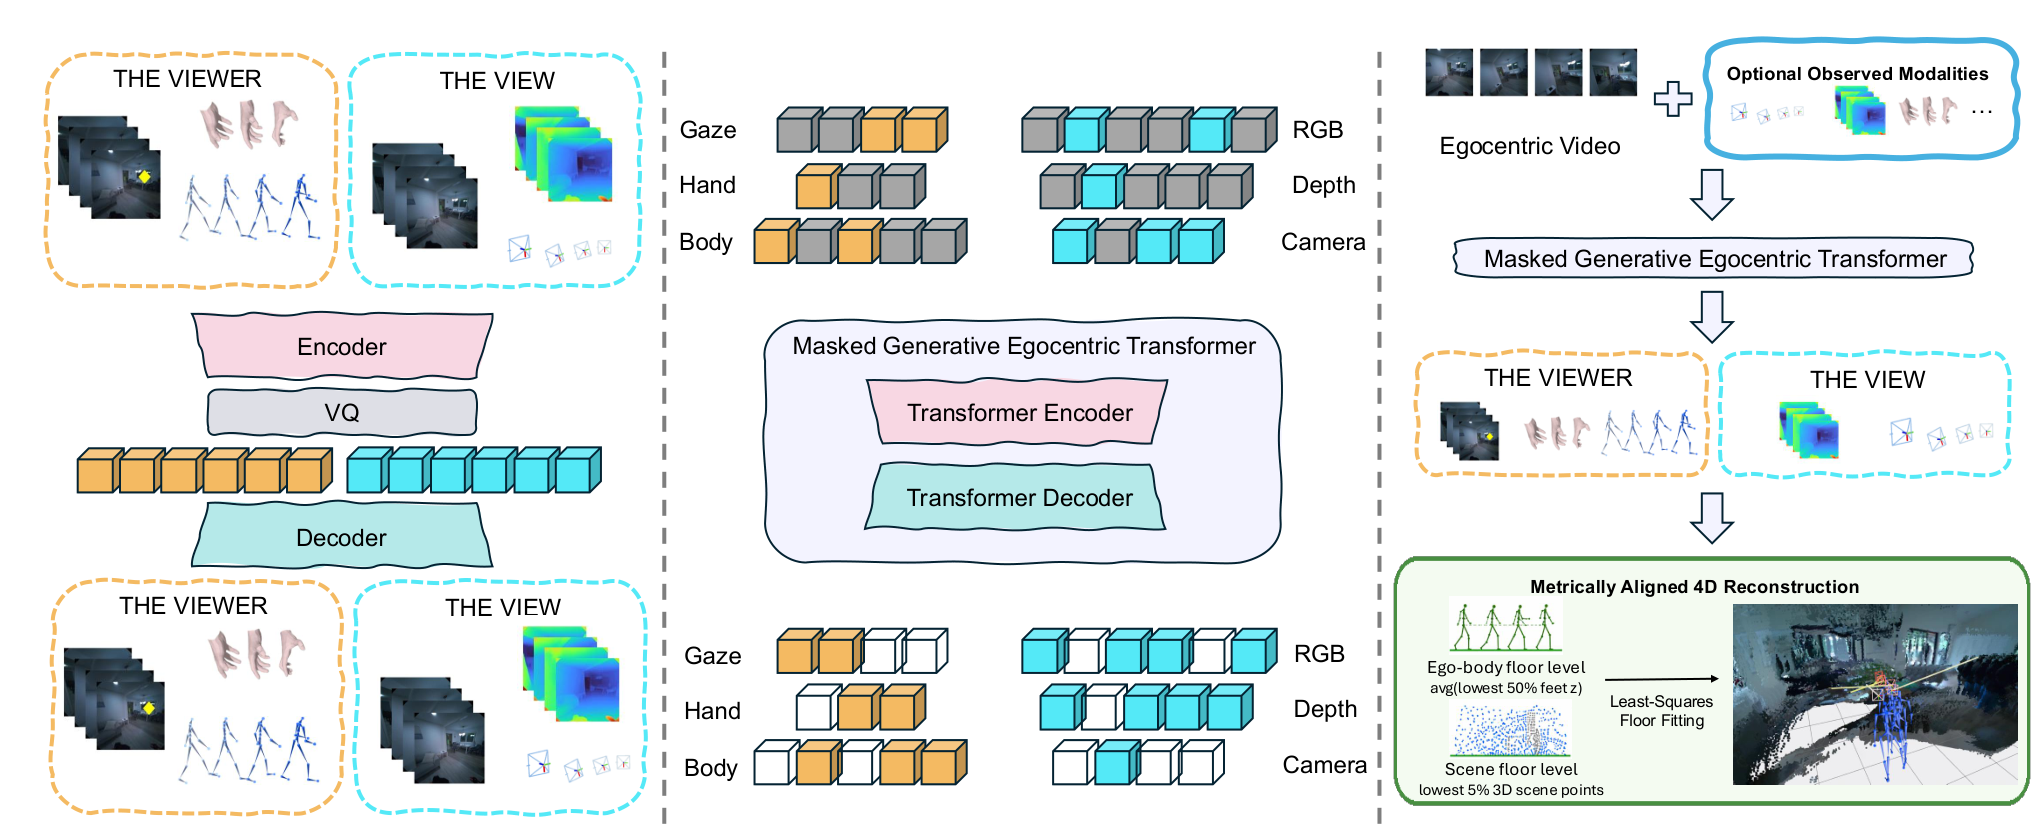
RGB 与深度使用 Cosmos tokenizer,codebook 大小 64,000。相机、视线、身体和手使用专门训练的 VQ-VAE:相机 256、视线 512、手 1024、身体 2048。身体与手的输入是 60 帧、21 关节、每关节 3D 坐标;$[2,3]$ 的时空 tubelet 压缩后,身体序列产生 $(60/2)\times(21/3)=210$ 个 token。
论文 Equation (2)。
每个 $\mathbf z_m=(z_{m,1},\ldots,z_{m,L_m})$ 都是来自模态专属词表的整数序列,$L_m$ 可因模态而不同。方括号表示在统一训练样本里组织这些 token,并不意味着不同词表共享同一个整数语义;模型仍通过 modality embedding 和专属输出头区分它们。
这里还有一个容易忽视的补丁:离散 RGB token 会损失纹理与边缘,论文额外用可训练 ViT 直接编码原始 RGB,得到连续的 $\mathbf x_{\mathrm{ViT}}$。它不作为预测目标,而是给 encoder 提供高频视觉上下文。Table 8 显示拿掉这条支路后,深度、视线、相机 ATE 与手部指标几乎都变差。
4.3 MGET:随机改变题目,逼模型学会跨模态补全
MGET 是 12 层 encoder、12 层 decoder、hidden dimension 768 的 T5 式结构。encoder 对所有可见模态进行全局 self-attention;decoder 的 self-attention 受模态分隔约束,同时通过 cross-attention 读取全部可见上下文。这样,身体目标 token 可以读取 RGB、相机或已知身体片段,但不同目标模态不会在同一解码步里任意相互泄漏。
论文 Equation (3)。
$\mathbf M$ 是随机二值 mask,$\mathcal V$ 与 $\mathcal M$ 分别表示可见和待预测 token 索引;连续 ViT 特征没有离散类别,因此不进入交叉熵求和。训练先从 Dirichlet 分布为各模态分配 2048 个输入 token 与 2048 个目标 token,再只对真实存在且被选为目标的离散 token 计算负对数似然。
为何随机掩码能产生“联合模型”?当同一身体序列的一部分可见、另一部分被遮住时,模型学时间运动先验;当 RGB 可见而身体全遮住时,模型学视觉到身体;当相机与深度可见而 RGB 被遮住时,它又学习另一种条件关系。论文把多任务学习变成了同一个损失下不断变化的条件概率题目。
作者对这一训练逻辑的原话是:“optimizing over all possible mask configurations allows this objective to act as an efficient proxy for learning the underlying joint distribution”。这里的关键词是 proxy:掩码损失是学习联合分布的训练代理,而不是对连续世界真实密度的显式、精确求值。
4.4 三步并行推理:不是逐 token 自回归
测试时 $\mathbf Z_{\mathcal V}$ 只含 RGB(以及发布模型中的连续 raw-clip 支路),其他目标先全部为空。作者采用 order-agnostic parallel decoding:总共 $s=3$ 步,每步选约 $n/s$ 个尚未预测的目标 token,同时估计并采样。这比逐 token 解码快得多,也是论文所谓“single feed-forward architecture”而非“只调用一次网络”的准确含义——完整采样仍包含多次前向。
依据 Appendix C 的 conditional/unconditional 两次前向与 CFG 权重写出的标准 logits 合成式。
$\ell_c$ 读取 RGB 和已生成状态,$\ell_u$ 隐去 RGB 但保留已生成状态;二者差值代表视频条件带来的方向,权重 $w=2$ 将其放大。随后使用 top-$p=0.8$ nucleus sampling;因此结果不是固定回归值,随机种子和采样分布会影响不可见肢体的具体解。
4.5 把相对深度放回米制世界
单目深度天然存在尺度与平移歧义。ReViV 先预测时间一致、仿射不变的相对深度,再利用身体脚部估计地面高度:取脚关节 $z$ 坐标最低 50% 的均值作为人体地面;场景点云取最低 5% 的点,解一个尺度 $s$ 与平移 $t$ 的最小二乘对齐。
对 Appendix D 文字算法的分析者形式化。
$q_z$ 是相对深度点云中候选地面点的竖直坐标,$h_{\mathrm{feet}}$ 是预测脚部形成的人体地面高度。这个步骤把“人体尺度”当作场景尺度锚点;若画面看不到地面,则可选用 VIPE 的 metric depth,拟合 $s\mathbf y_{\mathrm{depth}}+t$ 到外部深度。
5. 论文与官方源码对应
官方仓库是完整实现,而非仅有 demo。以下对应关系只说明公开版本如何落地,不把仓库后续工程改动倒推为论文 v1 的原始实验条件。
5.1 Dirichlet token budget:不是每个模态平均分配
# reviv/data/masking.py:157-164
input_alphas = torch.tensor([mod["input_alphas"] for mod in modality_info.values()])
input_alphas = rearrange(input_alphas, "nmod nmix -> nmix nmod")
self.input_dirichlets = [
    Dirichlet(torch.clamp(input_alpha, min=eps))
    for input_alpha in input_alphas
]
target_alphas = torch.tensor([mod["target_alphas"] for mod in modality_info.values()])
target_alphas = rearrange(target_alphas, "nmod nmix -> nmix nmod")
self.target_dirichlets = [
    Dirichlet(torch.clamp(target_alpha, min=eps))
    for target_alpha in target_alphas
]
配置为各模态提供 $\alpha\in\{0.01,0.1,1,10\}$ 的混合。小 $\alpha$ 会产生偏向少数模态的极端分配,大 $\alpha$ 更均匀;混合训练让模型既见到 1-to-1 题,也见到多条件、多目标题。
5.2 Encoder 全局看条件,decoder 按模态限制自注意力
# reviv/models/reviv_model.py:474-477
if self.decoder_sep_mask:
    sep_mask = (
        repeat(mod_mask, "b n2 -> b n1 n2", n1=N)
        != repeat(mod_mask, "b n1 -> b n1 n2", n2=N)
    )
    adapted_attention_mask = adapted_attention_mask | sep_mask
这对应 Algorithm 1 的“encoder unrestricted global self-attention / decoder intra-modal self-attention + inter-modal cross-attention”。目标手 token 通过 encoder context 获取 RGB 等跨模态信息,而不是直接偷看另一目标模态尚未确定的 token。
5.3 公开 demo 的三步 ROAR/MaskGIT 式解码
# demo_infer.py:395-408
return build_chained_generation_schedules(
    cond_domains=cond_domains,
    target_domains=[target_domain],
    tokens_per_target=[num_tokens],
    autoregression_schemes=["roar"],
    decoding_steps=[3],
    token_decoding_schedules=["linear"],
    temps=[0.01],
    temp_schedules=["constant"],
    cfg_scales=[2.0],
    cfg_schedules=["constant"],
    cfg_grow_conditioning=True,
)
论文 Appendix C 的 $s=3$、CFG $w=2$ 在 demo 中直接可见。仓库逐个目标模态生成以控制显存,所以“联合模型”指共享概率模型与权重,不等于 demo 一次函数调用同时吐出所有数组。
6. 实验分析:最强证据与不占优结果都看
6.1 身体运动:不输入相机,也能超过吃 GT 相机的模型
身体实验只在完全未参与训练的 Aria Digital Twin(ADT)上评测,共 3,185 个 clip。GA-MPJPE 对整个序列做一次 Sim(3)/Procrustes 对齐,关注全局轨迹与姿态;PA-MPJPE 每帧独立对齐,更偏局部姿态。FID 和 TMR embedding cosine similarity 则衡量动作分布真实感与配对语义。
| 方法 | 相机输入 | GA ↓ | PA ↓ | Similarity ↑ | FID ↓ | 时间/clip ↓ |
|---|---|---|---|---|---|---|
| EgoAllo | VIPE | 227.6 | 167.5 | 0.529 | 1.069 | 101.0 s |
| EgoAllo | GT camera | 198.4 | 136.8 | 0.556 | 1.160 | 72.5 s |
| UniEgoMotion | VIPE | 130.5 | 98.4 | 0.572 | 1.087 | 37.6 s |
| UniEgoMotion | GT camera | 105.8 | 88.7 | 0.591 | 1.098 | 9.1 s |
| ReViV | 无 | 111.5 | 88.6 | 0.751 | 0.442 | 0.7 s |
最有说服力的不是 GA 的冠军——它仍比使用 GT 相机的 UniEgoMotion 差 5.7 mm——而是 ReViV 在没有相机输入时,PA 几乎相同,动作相似度和 FID 大幅更好。这说明联合模型确实减少了对外部轨迹的依赖;但由于 GA 经过对齐,表格仍不能证明绝对米制位置已经完全准确。
6.2 手部:速度优势最明显,遮挡补全最符合生成建模动机
| 数据集 | 指标 | HaMeR | Dyn-HaMR | ReViV |
|---|---|---|---|---|
| HoloAssist | GA / RA / PA ↓ | 59.5 / 57.9 / 32.9 | 49.6 / 31.5 / 23.0 | 23.5 / 29.7 / 10.5 |
| HOT3D | GA / RA / PA ↓ | 94.4 / 74.1 / 48.1 | 107.7 / 46.9 / 32.0 | 38.2 / 48.1 / 13.6 |
| ARCTIC | GA / RA / PA ↓ | 95.9 / 39.2 / 28.6 | 76.9 / 33.3 / 22.4 | 35.1 / 33.0 / 13.7 |
| TACO | GA / RA / PA ↓ | 52.0 / 39.3 / 29.1 | 48.0 / 32.5 / 23.5 | 20.3 / 25.2 / 9.4 |
| 平均推理时间 | 秒/clip ↓ | 72 | 280 | 0.7 |
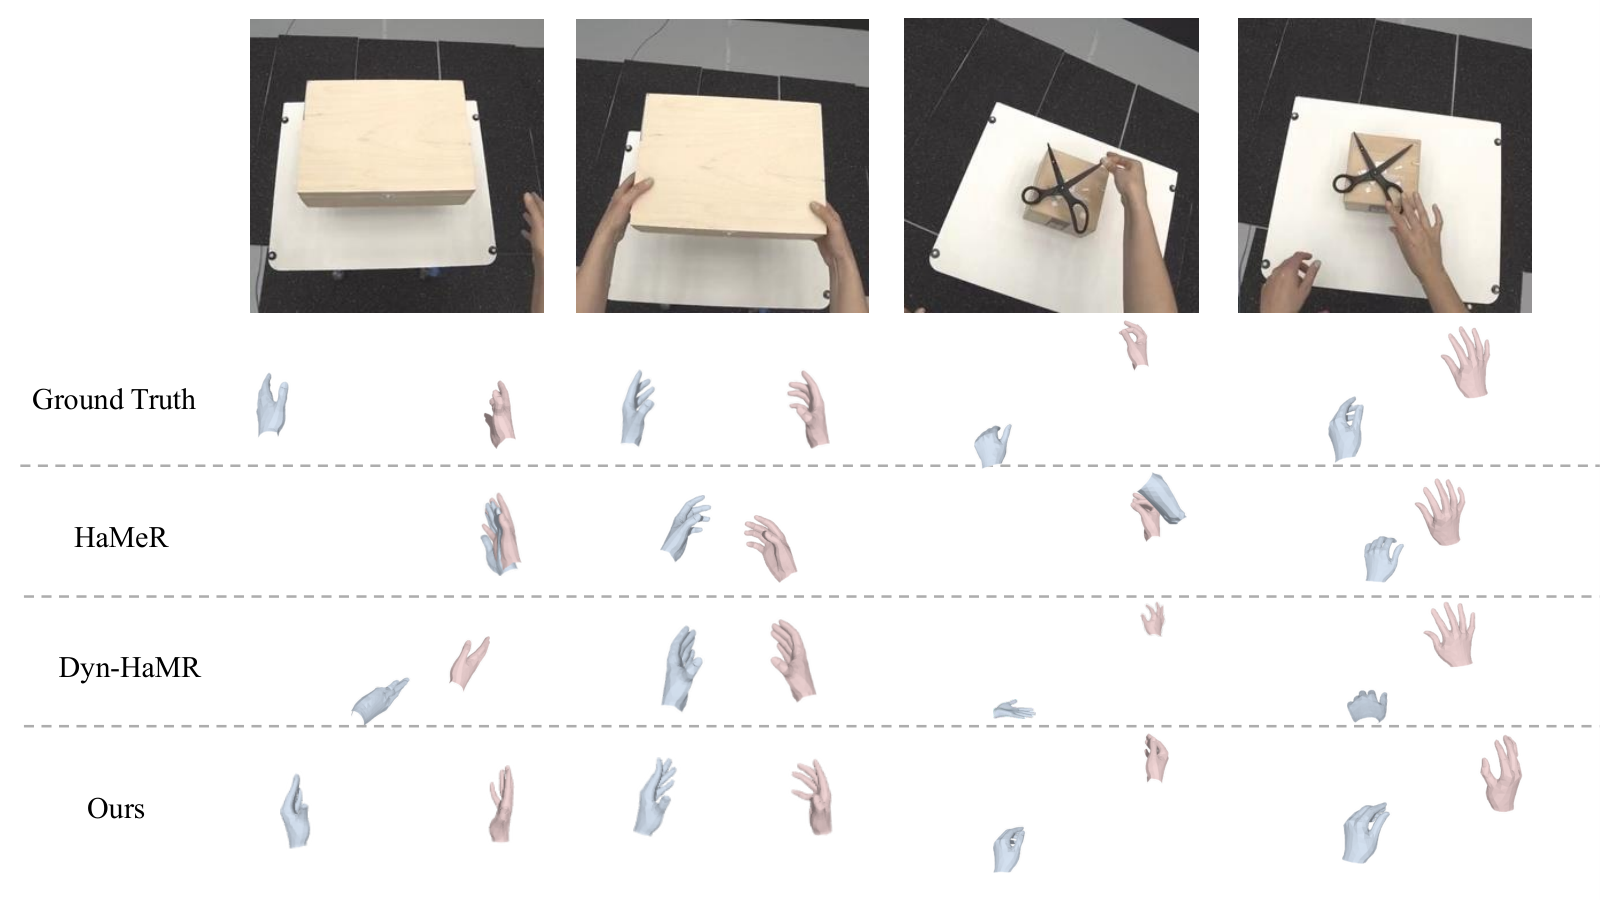
HoloAssist 对 Dyn-HaMR 只抽样 3,000 个 clip,因为其测试时优化过慢;因此速度与精度比较遵循论文协议,但不是每个方法都在完整 27,910 个验证 clip 上运行。即便考虑这一点,0.7 秒对 280 秒的量级差仍很大。
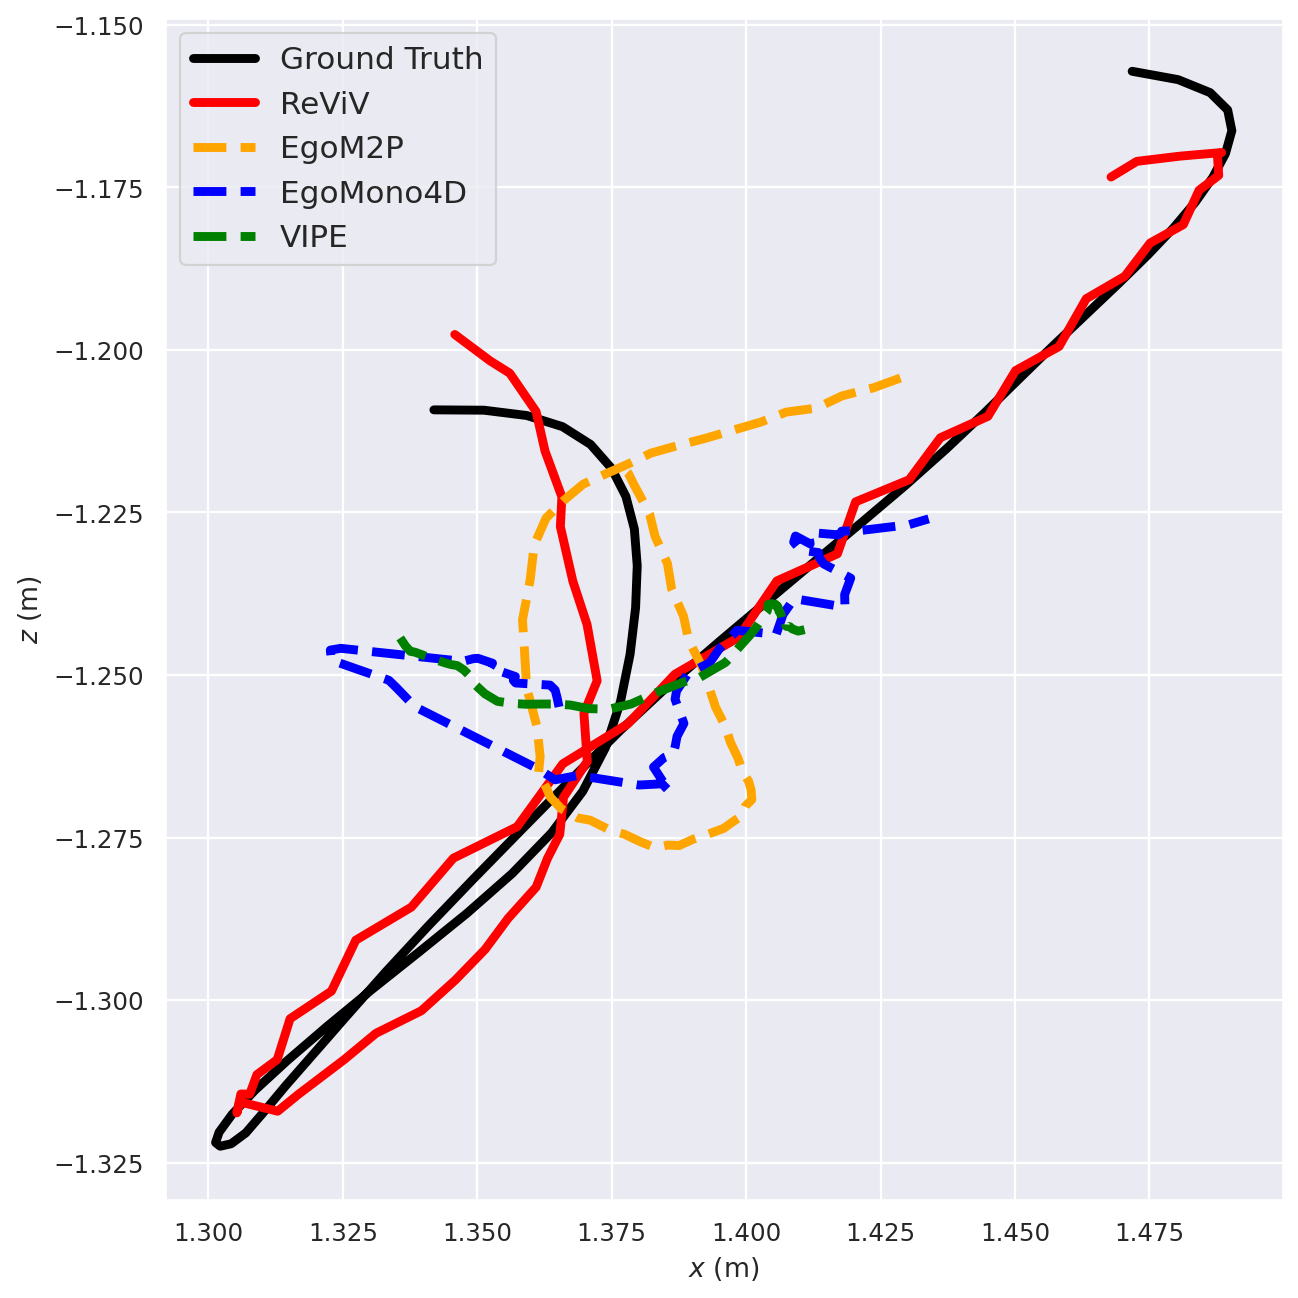
6.3 相机、视线与深度:统一模型并非每项都第一
| 方法 | 时间 ↓ | Camera ATE ↓ | RTE ↓ | RRE ↓ | Gaze MSE ↓ | Depth Abs Rel ↓ | $\delta_{1.25}$ ↑ |
|---|---|---|---|---|---|---|---|
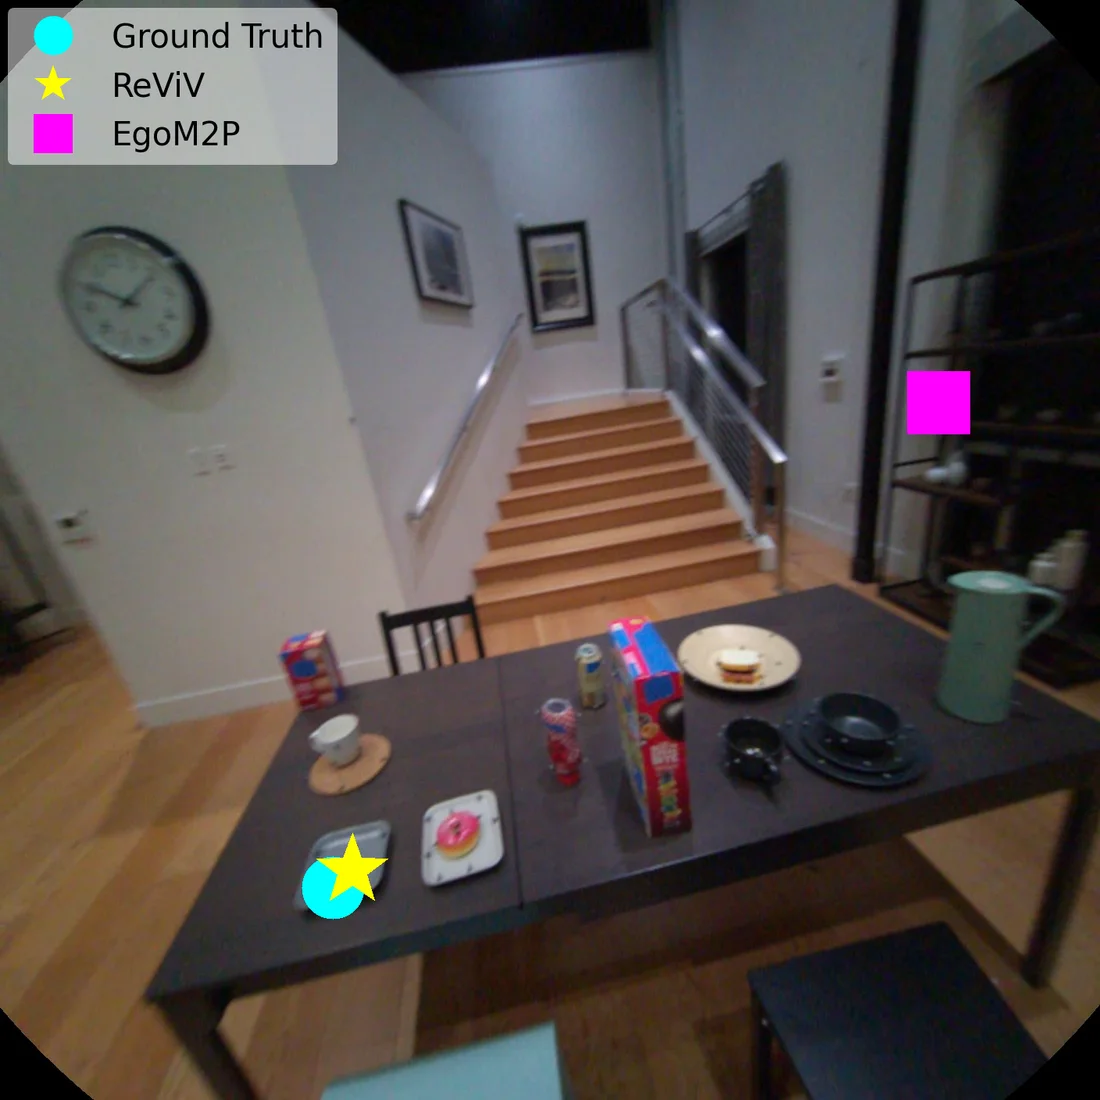
| EgoM2P | 0.7 s | 0.030 | 0.009 | 1.290 | 0.0311 | 0.458 | 30.3 |
| EgoMono4D | 14.2 s | 0.051 | 0.015 | 1.307 | — | 0.150 | 83.9 |
| VIPE | 25.8 s | 0.005 | 0.009 | 1.307 | — | — | — |
| ReViV | 0.7 s | 0.015 | 0.009 | 1.279 | 0.0211 | 0.265 | 56.5 |
相机轨迹全部在整段 clip 上用 Sim(3) 对齐后评测。VIPE 通过 dense bundle adjustment 获得最好 ATE;ReViV 的优势是单次前馈速度与最低 RRE,而不是全面超过几何优化。深度上,EgoMono4D 借助 UniDepth 预训练明显领先,ReViV 只比 EgoM2P 好;这是论文对“统一离散表示”的最直接反例。
6.4 消融:联合训练、掩码分布、数据规模和容量分别做了什么
| 变体 | Body GA ↓ | Body FID ↓ | Camera ATE ↓ | Depth Abs Rel ↓ | 解释 |
|---|---|---|---|---|---|
| Full ReViV | 111.5 | 0.442 | 0.015 | 0.265 | 完整联合训练 |
| BodyData | 134.0 | 0.478 | — | — | 只用含身体标签的数据 |
| Body specialist | 200.3 | 0.623 | — | — | RGB→body 单任务 |
| 1-to-1 mask | 158.3 | 0.548 | 0.036 | 0.401 | 缺少丰富多条件组合 |
| Uniform mask | 172.7 | 0.665 | 0.053 | 0.494 | 密集视频 token 挤压稀疏人体 token |
| Tiny (~127M) | 143.1 | 0.486 | 0.026 | 0.337 | 容量不足以覆盖复杂联合分布 |
这组消融最强地支持了论文的核心主张:单任务专家不是更专注,反而因失去跨模态监督而大幅变差;只在有身体标签的数据上训练也更差,说明没有身体标签的 RGB/深度/相机数据仍能塑造共享视觉与运动表征。但“更多参数必然更好”的说法证据较弱,因为论文只比较 full 与一个 tiny 点,没有完整 scaling curve。
7. 讨论:ReViV 应该被理解成什么
7.1 它是多模态 4D 重建器,不是显式物理世界模拟器
模型学习的是 2 秒左右 clip 内多模态信号的统计联合关系。它没有 action-conditioned transition、长期状态记忆、物体永久性或规划目标,因此不应把“viewer-view 4D”直接等同于可 rollout 的 world model。更准确的定位是:一个能从第一视角观测恢复短时人体—场景状态的多模态感知基础模型。
7.2 “不依赖 task-specific priors”需要限定
主模型确实没有调用外部身体扩散器或在线 SLAM;但 RGB/深度依赖预训练 Cosmos tokenizer,深度伪标签来自 Video Depth Anything,地面不可见时还可用 VIPE metric depth 锚定。论文的贡献是减少推理主路径对重型专家与优化的依赖,而非完全不使用外部模型生态。
7.3 联合建模最大的价值是避免误差级联
若相机→身体是硬串联,轨迹误差必然进入人体;联合模型允许视觉证据、运动先验与场景几何在共享 hidden state 内相互校正。身体实验中不输入相机仍超越部分 GT-camera baseline,是这一机制最有力的外部表现。不过模型内部相关性并不保证几何可解释性,失败时也更难定位到底是哪一模态误导了其他模态。
8. 局限分析
8.1 作者明确承认:离散化伤害密集回归
作者写道:“the quantization process inevitably discards some high-frequency spatial details”。这与深度表中 ReViV 落后 EgoMono4D 的结果一致。
连续 ViT 支路能补回输入视觉细节,却不能完全消除目标深度 token 的量化上限。一个合理方向是在离散 token 给出全局结构后,再用连续 diffusion/refinement decoder 恢复边缘和薄结构;这也是作者提出的未来方向。
8.2 分析者判断:训练资源和数据治理门槛很高
主训练为 256 张 H100、约 24 小时,单个运动 tokenizer 还需 4 张 H100 训练约 72 小时。数据来自九个生态、带各自许可,官方仓库不再分发训练集或派生标注。代码公开并不等于普通实验室可完整复现预训练。
8.3 分析者判断:短 clip 结果不能证明长期 4D 一致性
公开 demo 处理约 2 秒窗口,身体/手 tokenizer 以 60 帧为基本单元。论文展示时间平滑和局部轨迹,但没有长时间闭环、重访一致性、累计漂移或跨窗口状态融合实验,因此“temporally consistent 4D”应理解为评测窗口内的一致性。
8.4 对齐指标会隐藏绝对坐标误差
身体 GA/PA 与相机 Sim(3) 对齐都移除了部分尺度、旋转和平移误差。它们适合比较姿态与轨迹形状,却不足以单独证明无需外部锚点即可得到准确米制世界。论文自身也通过 floor fitting 或 VIPE metric depth 补足这一缺口。
8.5 生成式补全可能“合理但不真实”
手完全不可见时,模型能生成符合运动学的手势,但单一 ground truth 并不一定是视频证据唯一支持的解。MPJPE 会惩罚另一种合理动作;反过来,视觉上顺滑也不保证真实发生。未来需要多样性、校准度和多假设覆盖率等评测,而不只是单样本点误差。
9. 结论
ReViV 的核心贡献不是又加了几个预测头,而是把第一视角 4D 重建从“任务串联”改写成“联合补全”。统一 token 接口、Dirichlet 多模态掩码、连续 ViT 旁路与三步并行解码共同支撑了这一改写:身体和手从时间/场景中获得先验,相机误差不再成为人体模型的强制输入,缺失标注的数据也能参与共享表征学习。
实验最扎实的部分是人体与手部:在完全 unseen 的 ADT 以及四个手部基准上,ReViV 同时取得精度和速度优势。最诚实的边界也很清楚:深度细节仍受量化限制,VIPE 的几何优化在 ATE 上更强,预训练成本巨大,长期一致性没有被系统评估。
来源与复核说明
- 论文 HTML v1:正文、附录、公式、表格和 Figure caption 的主要事实来源。
- 官方项目页:公开定性结果和项目说明。
- 官方 GitHub:模型、masking、推理 schedule、配置和发布权重状态。
- 本文未运行模型或重新计算指标;所有实验数字均来自论文 v1,源码分析基于 2026-08-12 获取的官方仓库 commit
de23a67。